RT-2란?(RT-2 vs pi0 vs VLANeXt 까지)
by DINHO
오늘은 VLA라는 개념의 시초 격인 RT-2: Vision-Language-Action Models Transfer Web Knowledge to Robotic Control 논문을 중심으로 VLA(Vision-Language-Action)의 시작을 살펴보겠습니다. 최근 pi0 과 VLANext 이야기를 했는데요. 어쩌다보니 역순으로 소개를 하게 되었네요!
RT-2를 처음 보면 아이디어 자체는 굉장히 단순합니다.
Action is another language.
즉, 로봇의 action을 language token처럼 표현하고, 기존 Vision-Language Model(VLM)이 action까지 직접 출력하도록 만들자는 것입니다.
그런데 이후의 VLA 연구를 보면 이 아이디어가 그대로 유지되지는 않습니다. π0에서는 Action Expert, Flow Matching, Action Chunking을 도입하면서 action을 다시 continuous space에서 다루기 시작했고, VLANeXt는 더 나아가 “VLA의 수많은 설계 선택 중 실제로 무엇이 중요한가?”를 통제 실험으로 분석합니다.
이번 포스팅에서는 RT-2의 Motivation과 Method를 먼저 정리하고, 이후 RT-2 → π0 → VLANeXt로 VLA 구조가 어떻게 발전했는지 살펴보겠습니다.
Motivation
최근의 LLM과 VLM은 Internet-scale dataset을 통해 매우 풍부한 semantic knowledge와 reasoning capability를 학습합니다.
예를 들어 VLM은 이미지 속 물체를 인식하는 것뿐만 아니라, 물체 사이의 관계를 파악하거나 주어진 상황에서 어떤 물체가 적절한지 추론할 수도 있습니다. 이런 능력은 다양한 실제 환경에서 동작해야 하는 general-purpose robot에도 굉장히 유용해 보입니다.
하지만 여기에는 두 가지 문제가 있습니다.
첫 번째는 robot data와 web data의 규모 차이입니다.
강력한 VLM은 웹에서 수십억 개의 image-text sample을 학습하지만, 실제 로봇 trajectory를 그 정도 규모로 수집하는 것은 현실적으로 어렵습니다. 따라서 robot data만으로 web-scale model 수준의 generalization을 얻기는 쉽지 않습니다.
두 번째는 더 근본적인 문제입니다.
VLM은 “말”을 하지만, 로봇은 “움직임”이 필요합니다.
VLM은 semantic label이나 text prompt를 이해하고 자연어를 출력합니다. 반면 실제 로봇은 다음과 같은 low-level action이 필요합니다.
\[[\Delta x, \Delta y, \Delta z, \Delta r_x, \Delta r_y, \Delta r_z, gripper]\]기존의 LLM/VLM 기반 robotics 연구는 주로 다음과 같은 형태였습니다.
VLM / LLM
   ↓
high-level planning
   ↓
robot skill / primitive
   ↓
low-level controller
   ↓
robot action
즉 VLM은 무엇을 해야 하는지를 결정하지만, 실제 motor control은 별도의 controller가 담당했습니다.
RT-2는 여기서 다음과 같은 질문을 던집니다.
Large pretrained VLM을 low-level robot control에 직접 연결할 수 있을까?
다시 말해,
VLM → planner → controller
가 아니라,
VLM → robot action
으로 만들고자 한 것입니다.
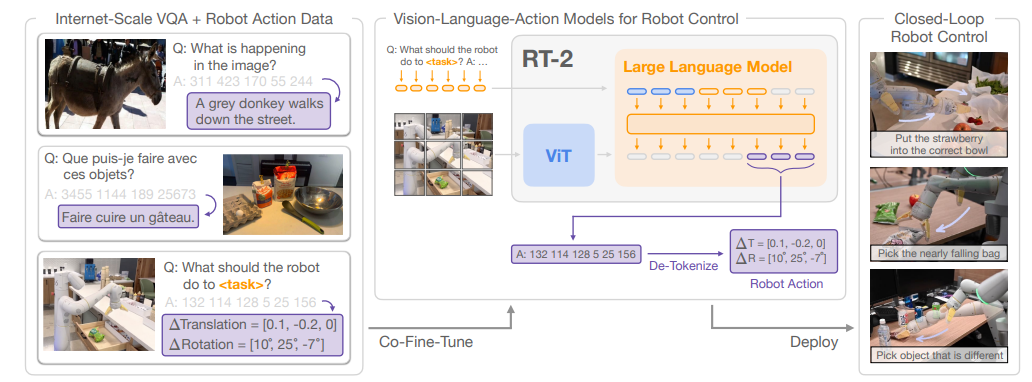
[그림 1] RT-2 전체 구조
RT-2의 핵심 아이디어는 이 문제를 아주 단순하게 해결합니다.
Robot action도 하나의 language로 표현하면 되지 않을까?
즉,
\[\boxed{\text{Action is another language}}\]입니다.
RT-2 Method
RT-2의 Method는 크게 다음 흐름으로 볼 수 있습니다.
Pre-trained VLM
      ↓
Robot action discretization
      ↓
Action tokenization
      ↓
Web data + Robot data co-fine-tuning
      ↓
Action token generation
      ↓
De-tokenization
      ↓
Closed-loop robot control
하나씩 살펴보겠습니다.
1. Pre-trained VLM을 그대로 사용
RT-2는 robot policy를 처음부터 새로 학습하지 않습니다.
이미 Internet-scale vision-language data로 pre-training된 PaLI-X와 PaLM-E를 가져와 VLA로 fine-tuning합니다.
핵심은 기존 VLM이 가지고 있던
- visual understanding
- language understanding
- semantic knowledge
- reasoning capability
를 robot policy 안으로 가져오는 것입니다.
즉 robot data에서는 physical skill을 배우고, web data에서 학습한 semantic knowledge를 이용해 그 skill을 새로운 상황에 적용하려는 것입니다.
\[\text{Robot Physical Skill} + \text{Web Semantic Knowledge} \rightarrow \text{RT-2}\]2. Continuous Action을 256개의 bin으로 변환
문제는 VLM이 기본적으로 text token을 출력한다는 점입니다.
Robot의 position이나 rotation 값은 continuous value이므로 그대로 language model의 output으로 사용할 수 없습니다.
RT-2의 action space는 크게 다음으로 구성됩니다.
- 6-DoF end-effector position / rotation displacement
- gripper extension
- episode termination command
그리고 continuous dimension을 각각 256개의 uniform bin으로 discretization합니다.
예를 들어,
\[\Delta x = 0.037\]이라는 continuous action이 있다면 이를 256개의 구간 중 하나에 대응시켜
continuous value
      ↓
256-bin discretization
      ↓
bin index
      ↓
action token
과 같이 변환합니다.
결국 robot action 전체는 여러 개의 integer token sequence가 됩니다.
\[\text{continuous action} \rightarrow \text{discrete bin} \rightarrow \text{text token}\]여기서 굉장히 재미있는 점은 모델 입장에서는 language와 action의 차이가 거의 사라진다는 것입니다.
일반적인 VQA가
Q: What is in the image?
A: a red cup
이라면, RT-2의 robot control은
Q: What action should the robot take to <task>?
A: 132 114 128 5 25 156 ...
처럼 표현할 수 있습니다.
즉 robot control 자체를 일종의 VQA-style next-token prediction problem으로 바꾼 셈입니다.
PaLI-X는 숫자에 해당하는 token을 그대로 사용할 수 있기 때문에 bin index와 integer token을 대응시키고, PaLM-E는 자주 사용되지 않는 256개의 token을 action vocabulary로 재사용합니다.
이렇게 하면 별도의 action-only output head를 새로 만들지 않고도 기존 VLM의 autoregressive output mechanism으로 robot action을 예측할 수 있습니다.
3. Web data와 Robot data를 함께 Co-Fine-Tuning
여기서 RT-2의 또 다른 중요한 부분이 Co-Fine-Tuning입니다.
단순히 pretrained VLM을 robot data로만 fine-tuning하지 않고,
\[\text{Web Vision-Language Data} + \text{Robot Trajectory Data}\]를 함께 사용합니다.
왜 이렇게 할까요?
Robot dataset은 web dataset에 비해 훨씬 작습니다. 따라서 robot data로만 fine-tuning하면 기존 VLM이 가지고 있던 visual concept이나 semantic knowledge를 잊을 수 있습니다.
따라서 RT-2는 fine-tuning 과정에서도 web-scale vision-language task를 계속 함께 학습합니다. 또한 작은 robot dataset이 training mixture에서 묻히지 않도록 robot data의 sampling weight를 높입니다.
결과적으로 모델은 동시에
Web data
→ semantic / visual knowledge 유지

Robot data
→ low-level action 학습
을 수행하게 됩니다.
이 부분은 RT-2의 generalization 성능에서 꽤 중요한 요소로 나타납니다.
4. Action Token을 다시 Robot Action으로 변환
Inference에서는 반대 과정이 수행됩니다.
Camera Image + Instruction
           ↓
          RT-2
           ↓
      Action Tokens
           ↓
      De-tokenize
           ↓
Continuous Robot Action
           ↓
        Robot
           ↓
 New Observation
새로운 observation을 다시 모델에 입력하면서 closed-loop control을 수행합니다.
다만 RT-2의 모델 크기는 상당히 큽니다. 가장 큰 RT-2-PaLI-X는 55B parameter이기 때문에 일반적인 on-robot GPU에서 직접 실시간 inference하기 어렵습니다.
논문에서는 모델을 multi-TPU cloud service에 배포하고 robot이 network를 통해 query하는 방식을 사용합니다.
- RT-2-PaLI-X-55B: 약 1–3 Hz
- RT-2-PaLI-X-5B: 약 5 Hz
정도의 control frequency를 보입니다.
RT-2가 얻은 것: Web Knowledge Transfer
RT-2에서 중요한 것은 단순히 큰 VLM을 robot controller로 사용했다는 것만은 아닙니다.
Robot demonstration에 직접 등장하지 않았던 semantic concept을 web knowledge를 통해 robot behavior로 연결할 수 있다는 점이 핵심입니다.
예를 들어 다음과 같은 instruction들이 가능합니다.
move apple to 3move cup to Googlepick up the bag about to fall off the tablepick animal with different colourmove banana to the sum of two plus one
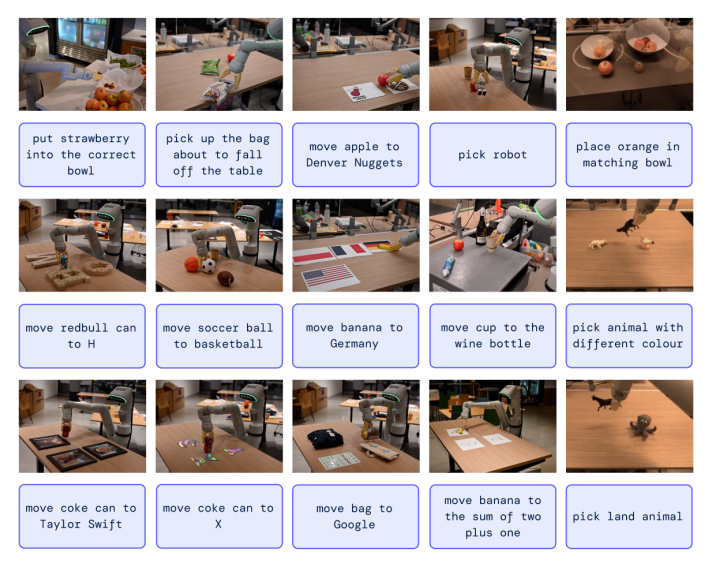
[그림 2] RT-2의 semantic generalization 예시
Robot data에서 숫자 3이나 Google logo에 물체를 가져다 놓는 demonstration을 직접 보지 않았더라도, VLM이 이미 가지고 있던 semantic knowledge를 활용할 수 있습니다.
다만 여기서 한 가지 중요한 점이 있습니다.
RT-2가 새로운 motor skill 자체를 web에서 배우는 것은 아닙니다.
예를 들어 move apple to 3이라는 instruction이 가능해지는 이유는
Web knowledge
→ 숫자 3을 인식

Robot data
→ pick & place skill 학습

둘을 결합
→ apple을 3으로 이동
할 수 있기 때문입니다.
따라서 RT-2의 핵심은
\[\boxed{ \text{새로운 semantic condition} + \text{기존 motor skill} \rightarrow \text{새로운 behavior} }\]로 이해하는 것이 좋습니다.
Limitation of RT-2
RT-2는 VLA의 시작을 보여준 중요한 연구이지만 한계도 명확합니다.
1. 새로운 motion을 배우는 것은 아니다
Web-scale knowledge를 추가하더라도 physical skill 자체는 여전히 robot dataset에서 보았던 skill distribution에 제한됩니다.
즉 semantic generalization은 크게 좋아질 수 있지만, robot data에 없던 완전히 새로운 dexterous motion이 갑자기 생기지는 않습니다.
논문의 failure case에서도 towel folding과 같은 precise/dexterous motion이나 training data 밖의 novel motion은 어려운 사례로 제시됩니다.
2. Real-time inference가 bottleneck이 될 수 있다
55B VLM을 이용해 매 순간 autoregressive inference를 수행하는 구조이므로 high-frequency control로 갈수록 계산 비용이 문제가 됩니다.
55B 모델의 1–3 Hz 수준은 pick-and-place와 같은 비교적 느린 manipulation에는 사용할 수 있지만, 빠르고 정밀한 continuous control에는 큰 제약이 될 수 있습니다.
3. Action을 정말 Language처럼 표현해야 할까?
여기부터는 RT-2 논문이 직접 명시한 limitation이라기보다, 이후 π0와 VLANeXt가 던진 문제의식에서 역으로 볼 수 있는 구조적 한계입니다.
RT-2에서는 continuous robot control을
\[\text{continuous} \rightarrow \text{discretization} \rightarrow \text{classification}\]으로 바꿉니다.
또한 한 timestep의 여러 action dimension을 autoregressive token sequence로 생성합니다.
이 방식은 VLM을 거의 수정하지 않고 robot policy로 만들 수 있다는 점에서는 매우 단순하고 강력합니다. 하지만 motor control 관점에서는 다음과 같은 질문이 생깁니다.
- continuous action을 굳이 discrete language token으로 바꿔야 하는가?
- action의 정밀도가 discretization resolution에 묶이지 않는가?
- 여러 action dimension을 sequential token prediction으로 생성하는 것이 가장 적절한가?
- 미래의 여러 action을 한 번에 예측하는 action chunking과 잘 맞는가?
이 질문에 대한 대표적인 다음 단계가 π0입니다.
What’s different in π0?
π0는 RT-2처럼 pretrained VLM의 semantic knowledge를 활용한다는 큰 방향은 유지합니다.
하지만 action을 다루는 방식은 크게 바뀝니다.
RT-2가
“Action도 language처럼 표현할 수 있다.”
에서 출발했다면, π0의 구조는 다음과 같이 해석할 수 있습니다.
“Semantic knowledge는 VLM에서 가져오되, continuous motor control은 action에 맞는 방식으로 처리하자.”
가장 큰 차이는 Action Expert, Flow Matching, Action Chunking입니다.
1. Action Expert
RT-2에서는 language와 action이 사실상 동일한 output mechanism을 공유합니다.
RT-2
Image + Language
      ↓
     VLM
      ↓
Action Tokens
반면 π0는 pretrained PaliGemma VLM에 robotics-specific state/action을 위한 별도의 parameter set을 추가합니다. 논문에서는 이를 Action Expert라고 부릅니다.
π0
Image + Language + Proprioception
              ↓
       Pre-trained VLM
              ↕
        Action Expert
              ↓
            Action
π0에서는 3B PaliGemma backbone에 약 300M parameter의 Action Expert를 추가합니다.
즉 VLM이 잘하는 semantic / visual representation과, robot action generation에 특화된 computation을 어느 정도 분리한 것입니다.
2. Flow Matching
RT-2의 action generation은
\[\text{continuous} \rightarrow \text{discretize} \rightarrow \text{next-token classification}\]입니다.
반면 π0는 conditional flow matching으로 continuous action distribution 자체를 모델링합니다.
RT-2
Continuous Action
      ↓
256-bin Token
      ↓
Classification

π0
Noise
  ↓
Flow Matching
  ↓
Continuous Action
따라서 action을 language token으로 강제로 변환할 필요가 없습니다.
π0는 이 continuous generative formulation이 high-frequency dexterous manipulation에서 필요한 precision과 multimodal action distribution을 다루는 데 적합하다고 설명합니다.
3. Action Chunking
RT-2는 기본적으로 현재 timestep에 해당하는 action을 생성하고, 다음 observation을 받은 뒤 다시 action을 생성합니다.
π0는 한 번에 여러 future action을 묶어 예측합니다.
\[A_t = [a_t, a_{t+1}, \cdots, a_{t+H-1}]\]π0에서는
\[H=50\]을 사용합니다.
즉,
RT-2
observation
    ↓
one action
    ↓
next observation
에 비해,
π0
observation
    ↓
[a_t, a_t+1, ..., a_t+49]
처럼 trajectory의 local future를 하나의 continuous action chunk로 모델링할 수 있습니다.
이 구조를 통해 π0는 dexterous task에서 최대 50 Hz의 control을 다룹니다.
결국 RT-2와 π0의 차이를 가장 간단히 정리하면 다음과 같습니다.
\[\boxed{ \text{RT-2: Action = discrete language token} }\] \[\boxed{ \pi_0: Action = continuous trajectory distribution }\]VLANeXt: 어떤 VLA Design이 실제로 좋은가?
π0 이후에는 VLA 구조가 굉장히 다양해집니다.
논문마다
- VLM backbone
- policy module
- VLM-policy connection
- action representation
- action learning objective
- camera input
- proprioception
- action chunking
등이 모두 달라졌습니다.
문제는 여러 요소가 동시에 바뀌기 때문에 정확히 어떤 design choice가 성능 향상에 중요한지 판단하기 어렵다는 점입니다.
VLANeXt는 이 문제를 정면으로 다룹니다.
RT-2/OpenVLA와 유사한 단순한 VLA baseline에서 시작해 500개 이상의 통제 실험을 수행하고, strong VLA를 만들기 위한 design recipe를 정리합니다.
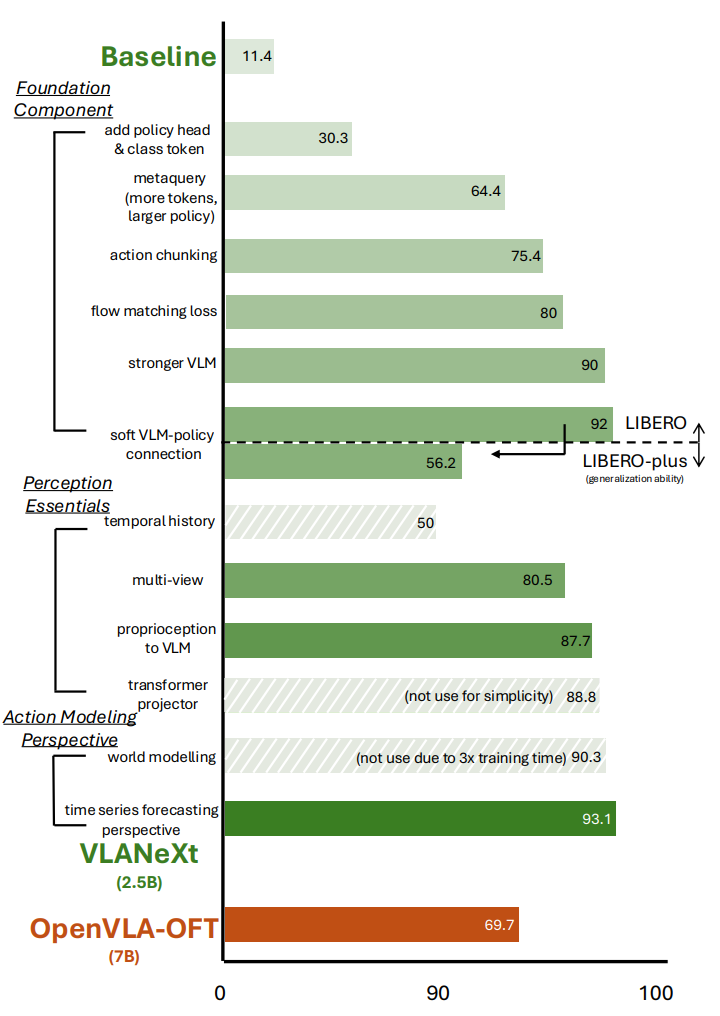
[그림 3] RT-2 style baseline에서 VLANeXt까지의 design trajectory
1. Text Token Reuse vs Separate Policy Module
VLANeXt의 baseline은 RT-2/OpenVLA와 비슷합니다.
continuous action
      ↓
256 bins
      ↓
rare text token reuse
      ↓
autoregressive classification
즉 Action is Language라는 RT-2 style design입니다.
VLANeXt는 먼저 다음 질문을 실험합니다.
Action을 정말 language와 완전히 같은 token space에서 예측할 필요가 있을까?
결과적으로 text token을 그대로 재사용하는 것보다 separate policy head를 두는 것이 더 좋은 성능을 보였습니다.
그리고 단순한 작은 head보다 여러 query token과 더 깊은 network를 사용하는 larger policy module(MetaQuery-style)이 추가적인 성능 향상을 보였습니다.
이 결과는 RT-2의 완전한 shared output space에서 점차 VLM과 action policy의 역할을 분리하는 방향으로 VLA가 발전했음을 보여줍니다.
2. Action Chunking
RT-2 style baseline은 one-step action prediction을 사용합니다.
VLANeXt에서는 여러 future action을 동시에 예측하는 action chunking을 적용했고, 더 긴 temporal horizon을 모델링하는 것이 action generation에 도움이 되는 것을 확인했습니다.
최종 VLANeXt는 chunk size 8을 사용합니다.
3. Classification에서 Continuous Objective로
VLANeXt는 action learning objective도 통제하여 비교합니다.
- Bin Classification
- VQ-VAE Classification
- Regression
- DDIM
- Flow Matching
등을 비교합니다.
여기서 한 가지 주의할 점이 있습니다.
초기 ablation 단계에서는 direct regression도 매우 강한 결과를 보였고 일부 설정에서는 flow matching보다 높은 성능을 보입니다. 따라서 단순히 “flow matching이 언제나 무조건 최고”라고 해석하면 안 됩니다.
다만 전체 VLA recipe가 강해진 설정에서는 flow matching이 precise control signal을 모델링하는 데 유리하다고 판단하여 최종 VLANeXt는 Flow Matching을 선택합니다.
결국 RT-2에서 시작된
Action = Token Classification
이 π0와 VLANeXt에서는
Action = Continuous Distribution
으로 이동하고 있는 것을 볼 수 있습니다.
4. VLM-Policy Connection
VLANeXt는 VLM과 policy module을 연결하는 방법도 비교합니다.
- Loose connection: VLM과 policy가 상대적으로 분리됨
- Tight connection: π series처럼 layer-by-layer로 강하게 연결
- Soft connection: layer-wise connection을 유지하되 learnable query를 latent buffer로 삽입
실험에서는 Soft Connection이 loose / tight 방식보다 조금 더 좋은 결과를 보여 최종 구조에 사용됩니다.
즉 semantic representation을 action policy에 전달하되, 두 space를 완전히 하나로 만들지도 않고 완전히 분리하지도 않는 중간 구조라고 볼 수 있습니다.
5. Perception과 Action Modeling에서도 중요한 Recipe
VLANeXt는 policy 구조 외에도 perception과 action modeling을 함께 분석합니다.
대표적으로 다음과 같은 결과가 있습니다.
- Multi-view: third-person + wrist camera가 single-view보다 효과적
- Proprioception: policy에 바로 넣는 것보다 VLM에 conditioning하는 방식이 효과적
- Temporal visual history: 단순히 과거 frame을 더 넣는 것은 성능 향상으로 이어지지 않음
- Frequency-domain auxiliary loss: action trajectory를 time-series로 보고 frequency-domain loss를 추가하면 적은 overhead로 성능 향상
- World modeling: 효과는 있지만 training cost가 약 3배 증가해 최종 recipe에서는 제외
최종적으로 VLANeXt는
Multi-view Image
+ Language Instruction
+ Proprioception
       ↓
   Qwen3-VL
       ↓
Learnable Meta Queries
   (Soft Connection)
       ↓
 Dedicated Policy Module
       ↓
 Flow Matching
       ↓
 Continuous Action Chunk
       +
Frequency-domain Loss
와 같은 구조가 됩니다.
VLA Architecture Evolution
지금까지 내용을 표로 정리하면 다음과 같습니다.
| RT-2 | π0 | VLANeXt | |
|---|---|---|---|
| 시기 | 2023 | 2024 | 2026 |
| 핵심 질문 | VLM을 robot policy로 직접 만들 수 있을까? | dexterous continuous control은 어떻게 할까? | 어떤 VLA design이 실제로 효과적인가? |
| VLM | PaLI-X / PaLM-E | PaliGemma | Qwen3-VL-2B |
| 주요 입력 | Image + Language | Image + Language + Proprioception | Multi-view Image + Language + Proprioception |
| Action representation | Discrete token | Continuous | Continuous |
| Action generator | VLM 자체 | Action Expert | Dedicated Policy Module |
| Training objective | Next-token classification | Flow Matching | Flow Matching + frequency loss |
| Action chunk | X | H=50 | H=8 |
| VLM-Policy 관계 | 동일 output space를 공유 | Action Expert와 tight하게 결합 | Soft connection |
| 핵심 의미 | Web knowledge를 robot action으로 transfer | Continuous / dexterous control 강화 | VLA design choice를 체계적으로 검증 |
이 변화에서 재미있는 점은 VLM 자체의 중요성이 줄어든 것이 아니라, VLM과 motor policy의 역할이 점점 더 명확하게 나뉘고 있다는 것입니다.
RT-2에서는 VLM의 language output mechanism을 그대로 robot action에 사용했습니다.
Vision + Language
      ↓
     VLM
      ↓
Action Token
π0에서는 VLM 옆에 Action Expert가 생겼습니다.
Vision + Language
      ↓
     VLM
      ↕
Action Expert
      ↓
Continuous Action Chunk
VLANeXt에서는 VLM과 policy module 사이의 interface 자체를 하나의 중요한 design variable로 보고, soft connection을 사용합니다.
Vision + Language + Proprioception
              ↓
             VLM
              ↕
       Learnable Queries
              ↕
          Policy Module
              ↓
   Continuous Action Chunk
저는 이 흐름을 다음 세 문장으로 정리할 수 있을 것 같습니다.
RT-2: “Action도 언어처럼 만들 수 있다.”
π0: “그런데 continuous action은 language와 다른 방식으로 다루는 것이 좋다.”
VLANeXt: “그렇다면 어떤 설계 선택이 실제로 중요한지 하나씩 검증해 보자.”
마무리
RT-2를 다시 살펴보면서 가장 인상적이었던 부분은 아이디어의 단순함이었습니다.
Robot control처럼 복잡해 보이는 문제를 action을 token으로 바꿔 VLM의 next-token prediction 문제로 만들어버린 것입니다. 이 간단한 formulation 덕분에 Internet-scale VLM이 가지고 있던 semantic knowledge와 reasoning capability를 low-level robot control까지 직접 가져올 수 있었습니다.
하지만 VLA가 더 정밀하고 dexterous한 manipulation으로 확장되면서 Action is Language라는 가정 자체를 다시 고민하게 됩니다.
π0는 Action Expert와 Flow Matching을 통해 language representation과 continuous motor control을 구분하고, action chunking을 이용해 고주파수 trajectory를 모델링합니다. VLANeXt는 여기서 더 나아가 이러한 설계들을 통제 실험으로 하나씩 검증하면서 VLM과 policy를 어떤 방식으로 연결해야 하는지 분석합니다.
결국 VLA의 발전 과정을 단순화하면 다음과 같이 볼 수 있습니다.
\[\boxed{ \text{RT-2: Semantic Knowledge를 Action Token으로 연결} }\] \[\downarrow\] \[\boxed{ \pi_0: Semantic Representation + Continuous Action Expert }\] \[\downarrow\] \[\boxed{ \text{VLANeXt: VLM-Policy Interface와 Action Modeling을 체계적으로 설계} }\]RT-2가 VLA라는 문제 자체를 열었다면, π0와 VLANeXt는 그 안에서 language understanding과 motor control을 어떻게 결합할 것인가라는 문제를 더 정교하게 다루고 있다고 생각합니다.
앞으로 다른 VLA 논문을 볼 때도 단순히 backbone의 크기만 보기보다는
- VLM과 policy가 어떻게 연결되는지
- proprioception이 어디에 들어가는지
- action을 discrete / continuous 중 무엇으로 표현하는지
- one-step action인지 action chunk인지
- objective가 classification / regression / diffusion / flow matching 중 무엇인지
를 중심으로 보면 모델 사이의 차이가 훨씬 잘 보일 것 같습니다.
Reference
- Brohan, A. et al., RT-2: Vision-Language-Action Models Transfer Web Knowledge to Robotic Control, 2023.
- Black, K. et al., π0: A Vision-Language-Action Flow Model for General Robot Control, 2024.
- Wu, X.-M. et al., VLANeXt: Recipes for Building Strong VLA Models, 2026.
Follow my github
